© 2026 武汉见山行科技有限公司 版权所有
Skip to content
返回应用详情
Woosh
支持文本、视频生成高品质逼真音效(仅可用英文提示词),适配各类音视频创作场景
注意:请在客户端中打开,如果没有客户端,前往下载 >>>
应用特点
系统要求
建议16GB以上内存。硬盘空间40GB以上。
macOS 15及以上版本,仅支持M系列芯片。
Windows10/11 64位,NVIDIA显卡,8GB以上显存。
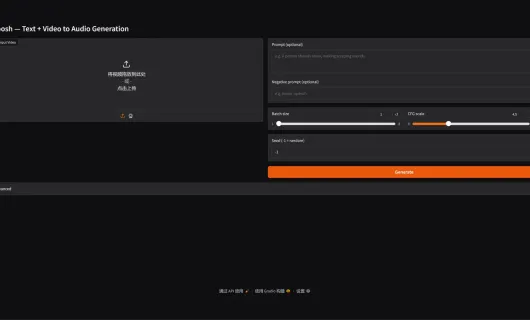
注意:NVIDIA显卡,请安装较新版本的驱动。截图预览
应用介绍
法律约束与适用场景: 本项目(Woosh)及其模型权重受 CC BY-NC-4.0 协议约束,严禁用于任何商业获利目的。
- 允许场景: 仅限于学术研究、个人兴趣学习、技术测试及非营利性的公开演示。
- 禁止场景: 严禁用于付费视频制作、商业广告、集成至收费软件/平台、或任何直接或间接产生经济利益的商业活动。 如有商业化需求,请务必联系版权方 Sony Research。
Woosh 是索尼 AI(Sony Research) 研发的开源音效生成基础模型,专注文本转音效、视频转音效两大核心场景,面向内容创作者、开发者与普通用户,可快速生成高质量、高真实感的环境音、动作音、特效音等音频素材。
核心功能
- 文本生成音效(T2A) 输入文字描述(如“雨声”“脚步声”“爆炸”),模型自动生成对应逼真音效。
- 视频生成音效(V2A) 上传视频,模型自动匹配画面生成同步音效,支持搭配文字提示精准控制风格。
- 基础组件
- 音频编解码器(Woosh‑AE):高质量压缩与还原音频,保障生成音质。
- 文本‑音频对齐模型(Woosh‑CLAP):让文字描述精准匹配对应声音。
重要提醒
目前该项目仅支持英文提示词,暂不支持中文提示词输入。
技术底层
基于潜在扩散模型(LDM)、流模型(Flow Matching) 与多模态对齐技术,兼顾生成质量与速度,提供本地推理、Gradio 网页演示、API 服务三种使用方式。
适用场景
短视频配音、游戏音效、影视后期、播客制作、互动媒体、AI 应用开发等。
项目特点
- 官方开源:索尼 AI 研发,代码与模型权重公开可下载。
- 双能力覆盖:文本/视频均可生成音效,适配不同创作需求。
- 易用性强:支持本地运行、网页 Demo、API 调用,零基础也能快速上手。
- 音质出色:专业级音效生成,满足内容创作与工业级使用。
许可证CC BY-NC-4.0, Apache v2, MIT