
© 2026 武汉见山行科技有限公司 版权所有
Skip to content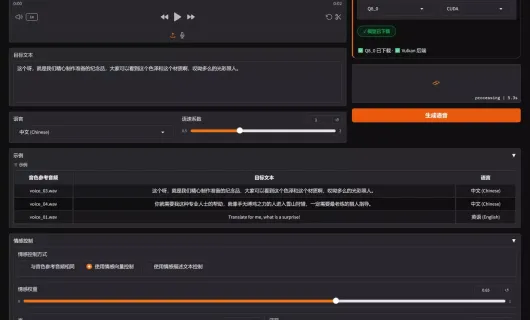
返回应用详情
截图预览
应用介绍
注意:轻量版使用GGUF量化模型,不支持情感参考音频,其他核心功能,如多语言合成、语速调节、情感向量控制等均保留。
IndexTTS2 是由 哔哩哔哩(Bilibili)开发的一款工业级可控高效零样本语音合成(TTS)系统,可将文字快速转换为自然流畅的语音,支持中文和英文场景,适合普通用户日常体验、开发者二次开发等多种需求。
功能与特点
- 发音纠正:在中文场景下,支持通过拼音纠正汉字发音,能快速修正读错的字符,比如遇到多音字或生僻字时,可以准确发音。
- 停顿控制:可通过标点符号控制任意位置的停顿,使语音表达更加自然流畅,符合人们日常说话的习惯。
- 零样本语音克隆:能在没有目标语音样本的情况下,仅依据说话人参考特征,合成风格一致的语音,实现零样本音色克隆,这意味着只需少量信息就能复刻特定声音风格。
- 高质量语音输出:集成了Conformer条件编码器和基于BigVGAN2的语音码解码器,提升了训练稳定性、语音音色相似度与音质,合成的语音MOS评分达到4.01,语音自然度和人声还原度高。
技术优势
- 混合建模方法:采用字符 - 拼音混合建模方法,专门针对中文场景优化,有效处理多音字、生僻字等问题,同时提升模型对句子节奏和语调的掌控能力。
- 数据丰富:使用数万小时的数据进行训练,涵盖多种类型的语音数据,确保合成语音在内容和音色上具有多样性与一致性。
- 性能领先:在多项测试中,如词错误率(WER)、扬声器相似度(SS)等指标上优于XTTS、CosyVoice2、Fish-Speech、F5-TTS等主流TTS系统。
相比1.x版本有诸多升级:
- 精准时长控制:IndexTTS2首次在自回归架构中实现了精准时长控制,支持两种生成模式,一种可通过明确指定生成的token数实现精确时长控制,另一种则自由生成,保持输入提示的韵律特征。而1.x版本时长不可控,IndexTTS2在影视配音等需严格音画同步的场景中具有明显优势,其音画同步误差<0.02%。
- 多种情感控制方式:IndexTTS2新增了四种情感控制方式,包括使用情感向量控制、使用情感描述文本控制以及默认的与音色参考音频相同的方式。用户可以根据需求选择不同的方式来精确调控合成语音的情感表达,而1.x版本的情感控制方式相对单一。
- 文本驱动的情感控制:内置T2E模块,基于Qwen-3微调模型,将自然语言描述转为情绪向量,用户只需输入文字描述,如“愤怒地质问”,即可驱动合成语音的情绪表现,降低了使用门槛,1.x版本可能缺乏这样便捷的文本驱动情感控制功能。
- 引入GPT潜在表征:IndexTTS2引入了GPT潜在表征,并设计三阶段训练策略,提升了强情感场景下的语音稳定性和清晰度,解决了数据不足和过拟合问题,使合成结果更加自然流畅。1.x版本在强情感表达时可能会出现口齿不清等问题。
- 性能提升:在技术性能上,多数据集实验表明,IndexTTS2在词错率、说话人相似度和情绪保真度上均超越当前最先进零样本TTS模型。例如,IndexTTS2的词错误率为1.883%,而1.x版本为1.921%,IndexTTS2降低了0.038%。
许可证bilibili Model Use License Agreement